Unity-ComputeShader线程与调度
Compute Shader(计算着色器)把工作组织成线程组,让 GPU 处理不必直接输出三角形或像素的任务。草地剔除、深度金字塔和图像处理,都可以按数据而不是按 Draw 来分配工作。
写出一个 Kernel 并不难,真正容易出错的是“有多少组、每组多少线程、谁能与谁同步、最后谁来消费结果”。本文用一个二维输出说明这些边界,接口以 Unity 2022.3 为例。
1. Dispatch 的参数不是像素数
[numthreads(8,8,1)] 规定每组 64 个线程。Dispatch(kernel,gx,gy,1) 则启动 gx×gy 个组。两者相乘,才是总线程覆盖范围。
假设图像是 100×70,需要组数 ceil(100/8)=13、ceil(70/8)=9,实际覆盖 104×72 个线程。多出来的线程必须显式判断越界。
2. 四种编号
| 语义 | 含义 |
|---|---|
SV_GroupID |
当前线程组的三维编号 |
SV_GroupThreadID |
当前线程在组内的三维编号 |
SV_GroupIndex |
组内三维编号展平后的索引 |
SV_DispatchThreadID |
整次 Dispatch 中的三维全局编号 |
关系是逐分量的 DispatchThreadID = GroupID * numthreads + GroupThreadID。组宽高必须与 Kernel 声明一致,不能把一维公式直接套到二维。
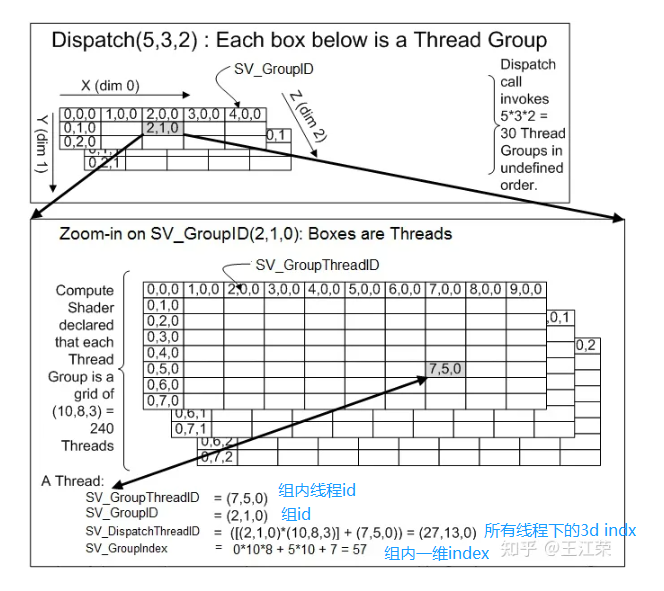
原笔记配图:线程组网格与线程编号的对应关系;图中使用 numthreads(10,8,3),与正文 8×8×1 示例不同,应分别计算。
3. 一个最小二维 Kernel
将下面保存为 .compute 文件;输出纹理应使用支持随机写的格式:
1 | |
C# 侧先设置 enableRandomWrite=true,再 Create();绑定纹理与尺寸后查询组大小计算 Dispatch。下面的 cs 和 rt 是已经赋值的 ComputeShader 与 RenderTexture:
1 | |
这段展示调度与越界关系,不包含组件生命周期;实际项目还需检查资源创建成功、设备支持,并在销毁时释放自己创建的资源。
4. 线程组是协作范围
groupshared 数据供组内线程协作,例如分块读取、归约与局部排序。组同步只约束这一组;不同组的执行先后不可依赖。
若整个图像要先完成阶段 A,再全体执行阶段 B,通常拆成两次 Dispatch,并由管线/API 保证资源依赖。不能让组 0 在共享变量里等待组 1,以此模拟全局屏障。
前面 Kernel 的提前返回只在没有组内同步时直接成立。若后面加入组同步,边界线程也必须遵守会合规则,往往需要用有效性掩码代替提前退出。
5. Buffer 布局与结果消费
StructuredBuffer 的 CPU 与 GPU 数据布局必须一致,尤其是三分量向量、布尔和混合精度字段。显式整理字段与 stride,比依赖不同后端恰好给出相同布局更可靠。
剔除草地时,一般保留源实例 Buffer,输出紧凑的可见实例 Buffer,再把可见数写进间接绘制参数。每帧应重置计数,处理容量上限与溢出,并保证绘制读到的是本次完成的结果。
回读到 CPU 可能引入等待。只为下一次 GPU 绘制准备数据时,优先让结果继续留在 GPU;需要统计时再考虑异步回读和延迟。
6. 组越大未必越快
更大的线程组可能提高复用,也可能增加共享内存、寄存器与同步开销,降低并发驻留。8×8、16×16 都是候选,不是通用最优值。
支持情况也不能概括成“安卓都支持”。应检查图形 API、设备功能、纹理格式与引擎能力,并提供必要的降级路径。
总结
Compute 的正确起点是定义数据范围与协作范围。把 Dispatch、组内线程和资源依赖分清,再讨论并行度、访存与组尺寸,才能避免把越界或竞态误认为平台兼容问题。