UE4-GPU性能优化方法与实践
性能优化首先是预算分配与问题定位,其次才是改算法。一个画面更快,可能来自减少了无效工作,也可能只是降低了质量;两者需要用相同条件的画面与数据分别说明。
本文整理 UE4 项目中的优化思路,面向传统光栅化与延迟管线。具体 Pass、命令和缓存策略应以项目分支为准,不能把旧项目经验直接套进 UE5 的 Nanite、Lumen 或 VSM 路径。
1. 先用毫秒确认瓶颈
60 FPS 的帧预算约为 16.67 ms,30 FPS 约为 33.33 ms。从 30 提到 60 需要省约 16.67 ms,从 120 提到 150 只需约 1.67 ms;相同 FPS 增幅并不代表相同工作量。
Game、Render、RHI 和 GPU 可以跨帧流水执行,不能把它们的时间简单相加。最长阶段通常提示吞吐瓶颈,但 VSync、帧率限制、CPU/GPU 同步和排队也会影响最终帧时间。先取消不必要的限帧,再观察轨迹。
GPU 已经很空闲时优化 Shader,可能只让 GPU 更空闲;RenderThread 卡在大量提交时,减少物体、材质与视图可能比缩图有效。
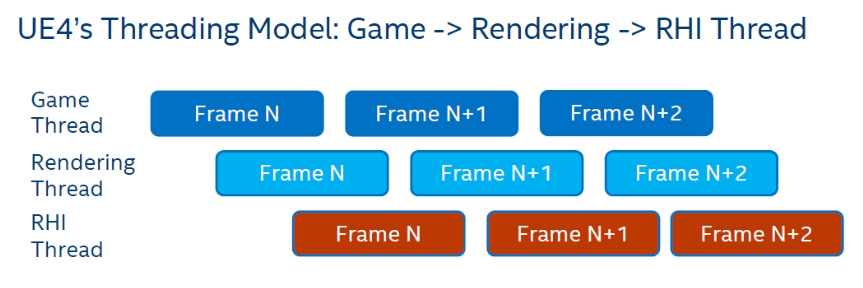
原笔记配图:UE4 的 Game、Render 与 RHI 线程跨帧流水示意。各阶段时间不能简单相加。
2. 固定一套可比较的场景
记录设备、构建配置、分辨率、画质、相机路径、热机时间与采样时长。分别保留均值、分位数和明显卡顿,不只记录单张截图上的 FPS。
测试应在目标硬件的独立构建中进行。编辑器、调试层、抓帧以及工具 Replay 都会影响耗时;抓帧用来解释工作组成,连续运行的数据用来判断体验。
每次只改变一个明确变量,记录修改、收益和画面代价。对比不成立时,宁可补测,也不要把波动写成优化成果。
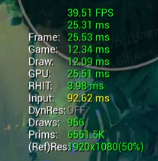
原笔记配图:旧项目的帧统计截屏,仅保留作为记录样本,不能直接作为当前设备的优化收益。
3. 沿 Pass 找不合理的工作
| 阶段 | 常见关注点 | 优化时的交换 |
|---|---|---|
| PrePass | 顶点、蒙皮、Mask 深度绘制 | 增加几何工作,换取后续遮挡收益 |
| BasePass | 材质、GBuffer 写入、像素覆盖 | 材质变体与带宽之间权衡 |
| Shadow | 投射物数量、级联和重复视图 | 降距离/频率可能产生阴影变化 |
| Lighting | 灯光覆盖范围、阴影过滤 | 缩小影响范围需要美术确认 |
| Translucency | 大面积叠层、排序与折射 | 减覆盖可能增加几何或制作成本 |
| PostProcess | 全屏分辨率、采样、中间 RT | 半分辨率需要重建与边缘处理 |
使用 stat unit、stat gpu 或 profilegpu 观察分布,再用平台工具定位具体 Draw。控制台变量是否存在、在当前构建是否生效,应先查询和核验,不能把旧命令列表当成所有版本通用接口。
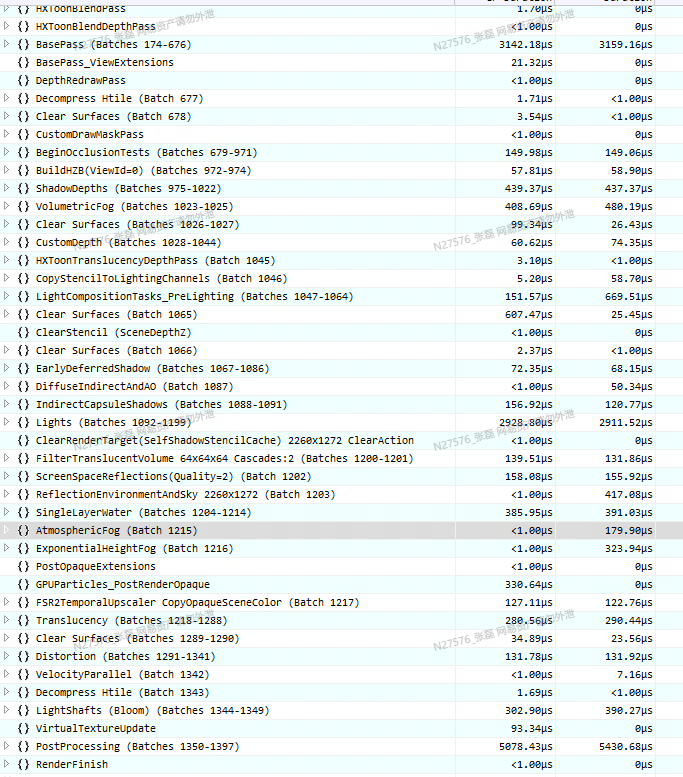
原笔记配图:原笔记收录的 GPU Pass 耗时列表,适合用来说明分阶段定位;不是本次新增的性能实测。
4. 先减少不可见与重复工作
距离裁剪、视锥裁剪与遮挡裁剪是不同层次。自定义间接绘制不能假定自动继承引擎的全部裁剪;阴影视图也可能需要与主视图不同的可见集合。
LOD 不仅能降低模型面数,也可降低材质复杂度、阴影更新频率或模拟精度。屏幕贡献比单纯距离更接近最终画面,但相机变化与阈值抖动需要滞回或渐变处理。
缓存适合变化少的结果:静态数据、阴影或预计算光照。缓存的正确性依赖失效条件,变换、灯光、材质或遮挡变化没有触发更新,就会把性能问题变成画面错误。
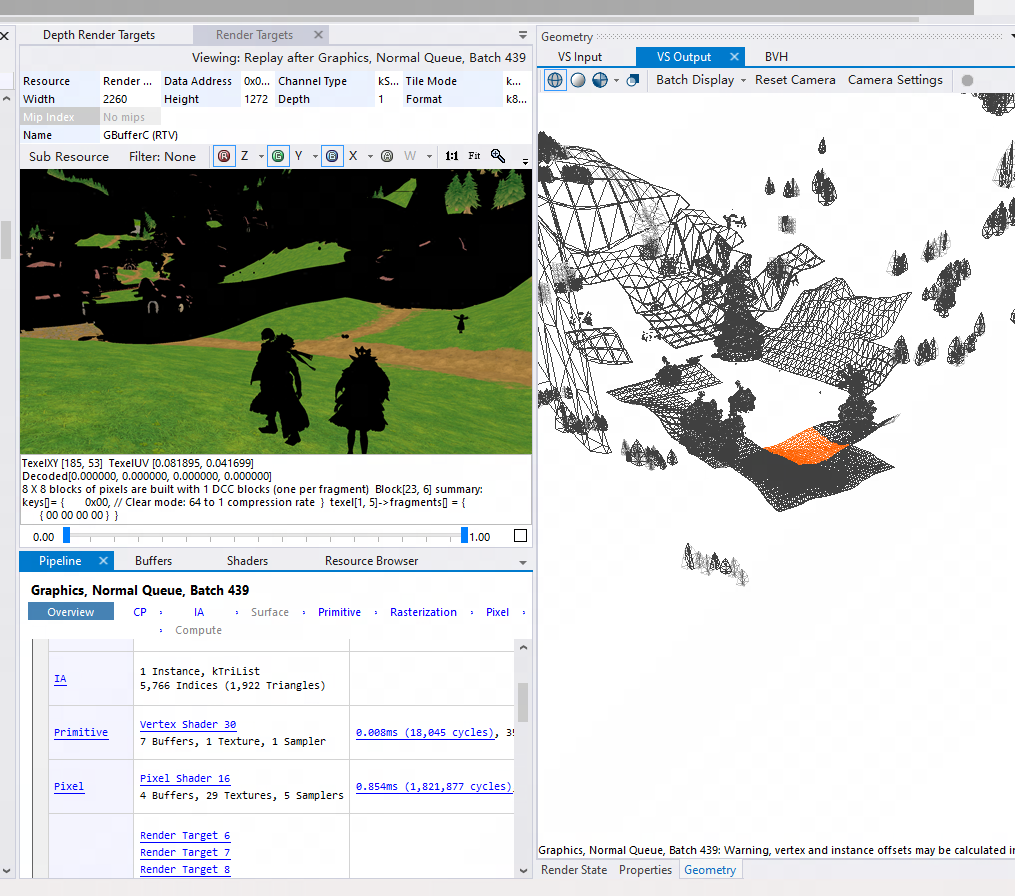
原笔记配图:旧场景与抓帧、调试视图,用来观察绘制对象和可见集合。
5. Overdraw 与 PrePass 的条件
不透明物体可以利用深度拒绝减少片元着色。discard、深度输出、透明混合及副作用会影响硬件采取哪些提前测试,但不能统一说成“有 Alpha Clip 就完全没有 Early-Z”。
Mask 材质在深度预通道与 BasePass 的覆盖、变形、LOD 和深度测试必须一致,才有机会省下重复工作。PrePass 的额外顶点与 Mask 采样可能超过收益,尤其是顶点密集、遮挡少的场景。
透明优化常从缩小空白覆盖、减少叠层和折射读取入手。贴片裁成更贴近内容的几何可以减少像素,但会增加顶点与制作开销,应按瓶颈选择。
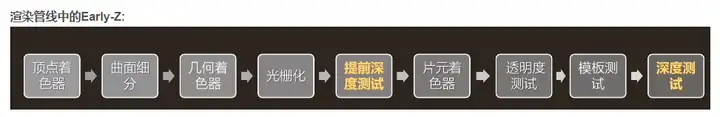
原笔记配图:旧资料中的深度测试逻辑位置。实际 Early-Z、Late-Z 与深度更新受硬件、状态和 Shader 行为影响。
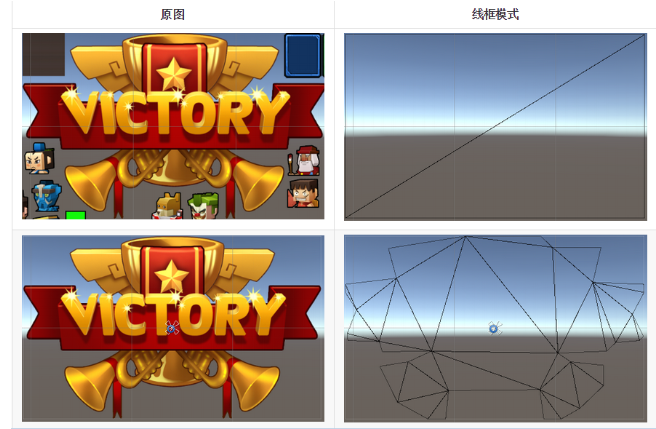
原笔记配图:贴片轮廓裁剪前后的几何对比:减少透明空白覆盖,同时增加顶点与制作成本。
6. Shader 优化不能按源码行数估价
一次纹理采样不固定等于八次显存访问;常量除法通常可被折叠;把 uv.xy 拆成两行也不必然更慢。编译器、纹理缓存、寄存器占用和目标架构决定真实执行成本。
把运算从像素搬到顶点,要先判断插值是否保持语义。非线性函数的“顶点计算后插值”通常不等于“插值后逐像素计算”;高光、归一化和视差都可能暴露差异。
母材质在变体数量和运行时路径间权衡。静态组合过多会增加构建、存储和预热成本;全做动态路径又可能增加指令与寄存器压力。
7. 分辨率与时间也是预算维度
把宽高各减半,像素数降为四分之一,但总 GPU 时间不会必然降为四分之一。几何、提交、固定开销和重建仍然存在。
时域积累能够摊薄采样,却引入运动重投影、历史拒绝与延迟。TAA 不是把 MSAA 的样本机械分到几帧;对静态和动态内容的处理条件不同。
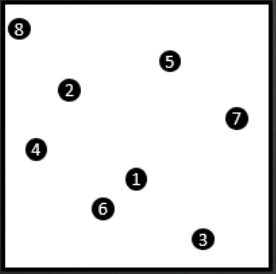
原笔记配图:用有限采样点近似区域平均的示意;点数减少不等于完整 Pass 成本按比例下降。
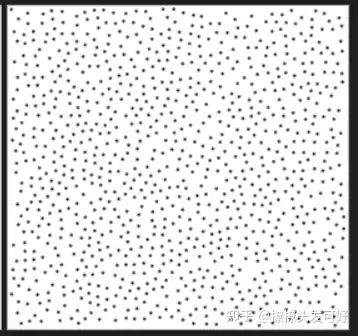
原笔记配图:稀疏采样分布的原记录参考图;采样模式会影响噪声、重复感和时域稳定性。
总结
有效优化是一条可追溯的链:固定条件、定位瓶颈、提出原因、实施改动、同时验收数据和画面。方法可以复用,收益必须重测;没有测试条件的性能数字,不应成为项目决策依据。